Case Study
UE 5.8 AnimGen:从 1,312 段有效动画到 Runtime Pose Generation
一次 UE 5.8 Preview 单卡实验:过滤 additive 数据,训练 AutoEncoder 与两阶段 Controller,并在 AnimBP 的 PIE 循环中验证单角色 runtime pose generation。
这次实验不是为了证明“AI 动画已经能上线”,而是回答一个更窄、也更有工程价值的问题:在 UE 5.8 Preview 里,AnimGen 能否从一组动画样本出发,经过训练,在 Animation Blueprint 的 runtime 节点里持续输出 pose?
答案是:单角色、_Uncontrolled Behavior 的端到端闭环跑通了;可控性、主观质量与多角色性能仍未被这次实验证明。
从“动画库”到“每帧 pose”的链路
1,374 AnimSequence
      │ inspect additive_anim_type
      ├─ remove 62 additive clips
      ▼
1,312 non-additive clips
      │ ToPoseVectors
      ▼
~800D pose ── AutoEncoder ──► 150D latent
                                  │
Behavior control ── Controller ───┤ flow matching + LOD distillation
                                  ▼
                            runtime latent
                                  │ Decoder
                                  ▼
                           AnimGraph output pose
AnimGen 的关键不是简单播放训练片段。训练时,AnimDatabase 把骨骼 pose 展平成向量;AutoEncoder 学习紧凑的 latent 空间;Controller 在 Behavior 条件下预测 latent 的演化;runtime 再经 Decoder 还原为 AnimGraph 可消费的 pose。
在这次快照里,runtime 推理走 LearningCore 的 CPU 路径,而不是 NNE 或 GPU。训练产物也是 UE 自有的神经网络数据,不应被当成通用 ONNX 模型或跨版本稳定格式。
数据关:1,374 不是最终训练规模
最早的导入结果是 1,374 段 AnimSequence。直接点击 AutoEncoder Train 会失败,因为数据中混有 additive 动画。Additive clip 表示相对基础 pose 的偏移,不能和完整 pose 序列按同一方式送进这条训练链。
路径名过滤并不可靠:AimOffset、Lean 与 Pose Base 分散在不同目录,命名也不能覆盖所有情况。最终采用的是资产本身的 additive_anim_type:
non_additive = [
    sequence
    for sequence in entries
    if sequence.additive_anim_type == AAT_NONE
]
结果是移除 62 段 additive clip,训练集从 1,374 收敛到 1,312。这两个数字描述的是本次样例库,不是 AnimGen 的最小数据要求或官方容量上限。
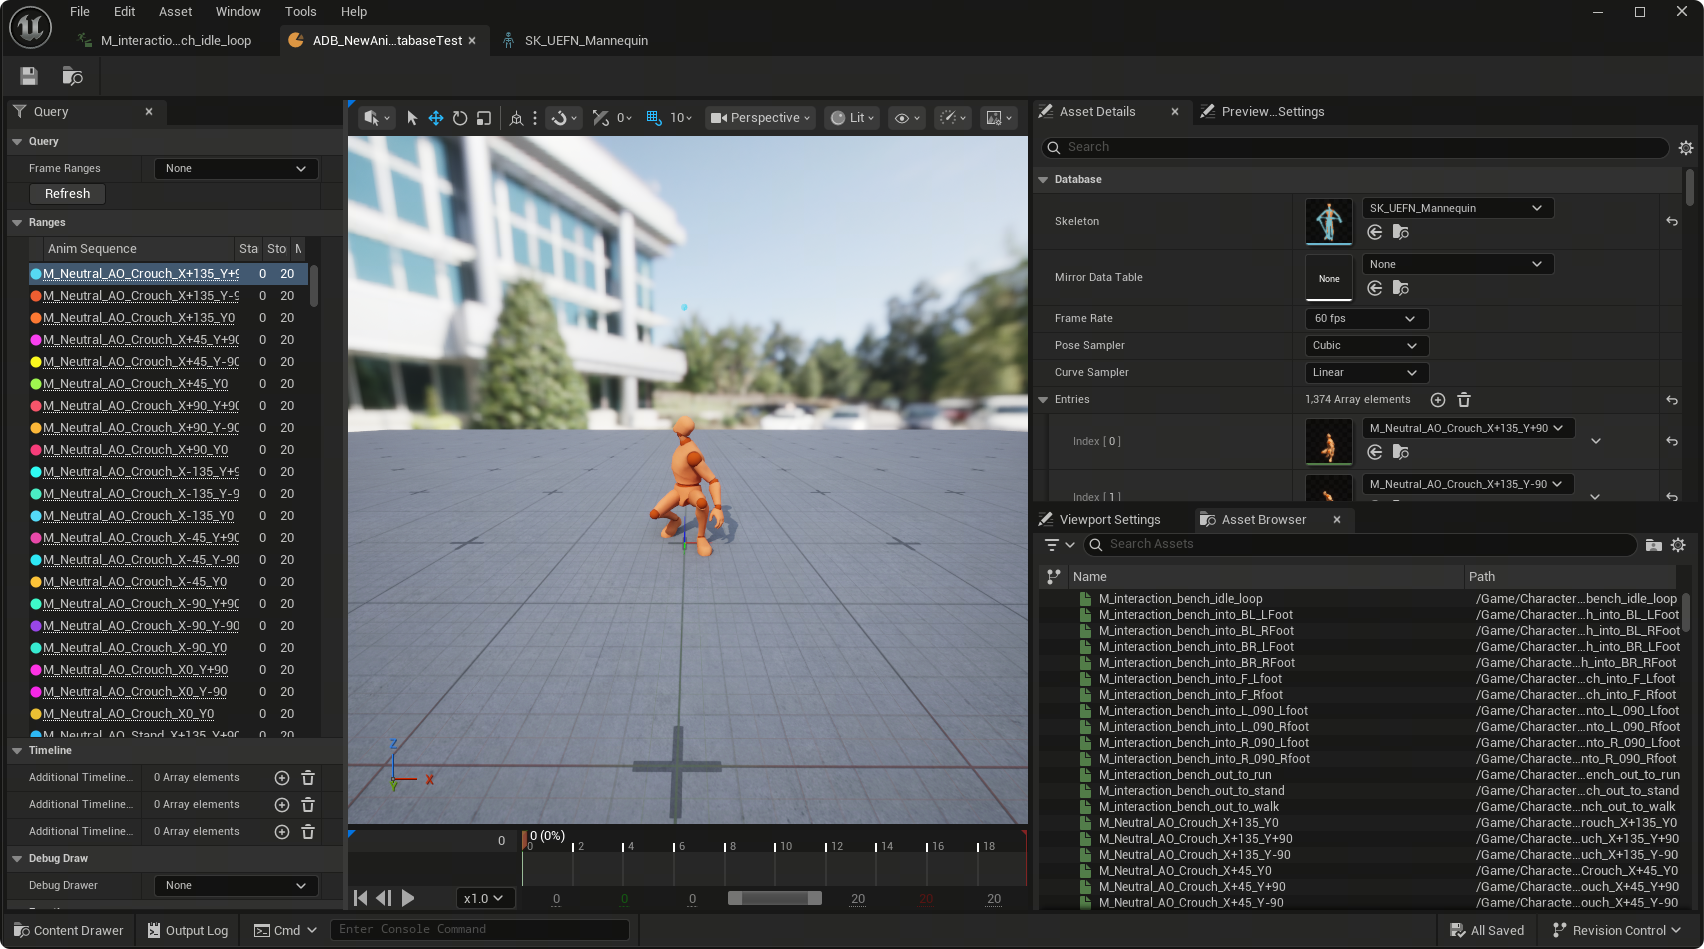
数据过滤后的验证也不只看 Entries 数字。我同时检查 Skeleton、Query frame ranges 与实际可采样条目,避免 skeleton 不兼容的 clip 被静默丢弃后仍误以为导入完整。
环境关:cuda.is_available() 不是兼容性证明
实验机使用 RTX 5060 Ti。UE 5.8 Preview 当时随项目安装的 PyTorch 2.5.1 + CUDA 12.4 无法为 Blackwell sm_120 执行需要的 kernel;仅检查 torch.cuda.is_available() 可能仍会得到误导性的结果。
我把验证改成三步:版本、分配、实际运算。
import torch

print(torch.__version__, torch.cuda.is_available())
x = torch.zeros(4, device="cuda")
print((x + 1).sum().item())
在本次项目环境中,将项目本地 Python 包替换为 PyTorch 2.7 + CUDA 12.8 后,实际 GPU op 才通过。这个版本组合是 2026-05 这台 RTX 5060 Ti 的实验记录,不是对所有机器的永久安装建议;复现时应先查 PyTorch 官方版本矩阵,再做真实 tensor 运算。
训练关:AutoEncoder 先建空间,Controller 再生成轨迹
AutoEncoder:四项 loss 不只是“重建误差”
AutoEncoder 把约 800 维 pose 向量压到默认 150 维 latent,再解码回 pose。训练目标由四部分组成:
| Loss | 约束对象 | 作用 |
|---|---|---|
loss_val |
重建 pose | 让 Decoder 还原输入姿态 |
loss_del |
帧间变化 | 让重建运动保留时间连续性 |
loss_reg_l1 |
latent 值 | 抑制 latent 无界增长 |
loss_reg_diff |
latent 帧间变化 | 让潜空间轨迹更平滑 |
归档 baseline 使用默认容量与 250k iterations。loss_val 从 0.025 降到 0.006;这说明优化目标在收敛,也通过了当时的数值健康检查,但它不等价于“肉眼质量已经达到生产标准”。
Controller Stage 1:flow matching Denoiser
Controller 接收噪声 pose、时间步与 Behavior control,学习从噪声指向目标 latent pose 的速度场。Stage 1 的主指标从 0.22 降到 0.09。这个阶段同时训练控制编码与 Denoiser,是整个生成模型的基础。
Controller Stage 2:把多步 teacher 蒸馏成 runtime LOD
训练阶段可以让 Denoiser rollout 多步得到较好的目标,runtime 却不能为每个角色每帧承担同样成本。Stage 2 因此冻结 Denoiser,用多步结果监督 LOD0/1/2 的单步网络。归档的 LOD 加权 loss 从 0.024 降到 0.015。
这份 baseline 的完整训练记录约 18 小时,运行在单张 RTX 5060 Ti 上。Loss 下降证明训练过程可运行并趋于稳定;它不能单独证明脚滑、接触、转向自然度或复杂控制的主观质量。
Runtime 关:PIE 需要一个每帧闭环
训练完成并不意味着把 Controller asset 拖进 AnimGraph 就会动。ControlObject 的生命周期是这个集成里最容易漏掉的一环:容器需要在 Animation Blueprint 初始化时创建,而 Behavior element 会被 AnimNode 每帧消费和 reset,所以 Update 阶段必须持续补充。
Event Blueprint Initialize Animation
  └─ Make Control Object
       └─ SET ControlObject

Event Blueprint Update Animation
  └─ Make Uncontrolled Behavior Control(Get ControlObject by ref)
       └─ SET ControlObjectElement

AnimGraph, every evaluated frame
  ControlObject + ControlObjectElement + Controller asset
       └─ Anim Gen Controller
            └─ Decoder
                 └─ Output Pose
如果只建 struct 变量却没有分配底层 ControlObject,或只在初始化阶段写一次 Behavior,PIE 会回到 reference pose。最终验证采用的是单角色、_Uncontrolled Behavior:角色在 PIE 中持续输出非 T-pose 的随机动作序列,完成了 AnimDatabase → AutoEncoder → Controller → AnimBP 的闭环。
这里刻意使用“跑通 runtime pose 输出”,而不是“生成了可用 locomotion”。_Uncontrolled 不要求角色遵循路径或速度目标,它适合证明管线连通,却不足以证明可控动画质量。
为什么没有用 DDP
PyTorch 支持 DistributedDataParallel,不代表嵌在 UE Editor 里的训练器能直接扩成多 rank。
AnimGen 的训练链由 UE 启动一个 Python 子进程,并用 Windows Named Shared Memory 交换 pose、控制数组、进度与网络权重。配置里的每个 GUID 在当前实现中按 1:1 attach 使用。直接增加 DDP rank 会让多个进程争用同一组共享 buffer 与权重写回位置,带来 race condition;这不是加一段 torchrun 参数就能解决的问题。
此外,这次环境只有一张 GPU,训练数据已经 mmap 到内存,Controller 的 Denoiser 规模也远小于需要 FSDP 才能装下的大模型。综合 IPC 改造成本与可获得收益,DDP 对这次实验没有实际价值。这个结论针对当前 UE↔Python IPC 架构与单卡条件,不代表 AnimGen 永远不能做多 GPU;要做到,需要先重设计共享内存协议、rank ownership 与最终权重汇聚。
已经证明什么,还没有证明什么
工程结论
这次实验最重要的结果不是一段“角色动起来”的 demo,而是把 AnimGen 的真实工程边界拆清楚了:
- 数据准备不是导入完成就结束,additive 类型与 skeleton 兼容必须先审计;
- 新 GPU 要验证真实 CUDA op,不能只看 availability flag;
- AutoEncoder 的重建空间和 Controller 的生成空间强耦合,重训 AE 就意味着重训 Controller;
- runtime 依赖每帧 ControlObject 消费循环,PIE 是训练成功之外的独立验证关;
- 单角色
_Uncontrolled闭环证明“管线可运行”,不证明“生产可用”。
下一步若继续推进,优先级应是可控 Behavior 的定量/主观 benchmark,其次才是多角色性能与工程化,而不是先追求更大的模型或分布式训练。