Explainer
AI 动画技术版图:生成、补帧、检索、约束与 Runtime Control
先拆开问题,再选择模型:用任务、运动来源与控制闭环理解 Motion Matching、In-betweening、Diffusion、Motion Token 与 Physics RL。
讨论 AI 动画时,人们常把所有东西都叫成“生成”:文本生成一段动作是生成,给首尾 Pose 补过渡也叫生成,运行时根据摇杆预测下一帧仍然叫生成。结果是模型名字越来越多,问题却没有被说清楚。
更实用的起点不是“Diffusion 还是 Transformer”,而是先回答三个问题:
- 你要解决什么任务? 是找已有动作、补中间帧、离线创作,还是每帧响应玩家输入?
- 动作从哪里来? 是动作库检索、逐帧预测、连续 latent 去噪、离散 motion token,还是物理策略?
- 结果怎么被约束和验收? 轨迹、关键帧、接触、碰撞、IK 和人工挑选,分别在哪一层发挥作用?
这三层分开以后,技术路线就不再是一串互斥名词,而是一组可以组合的工程部件。
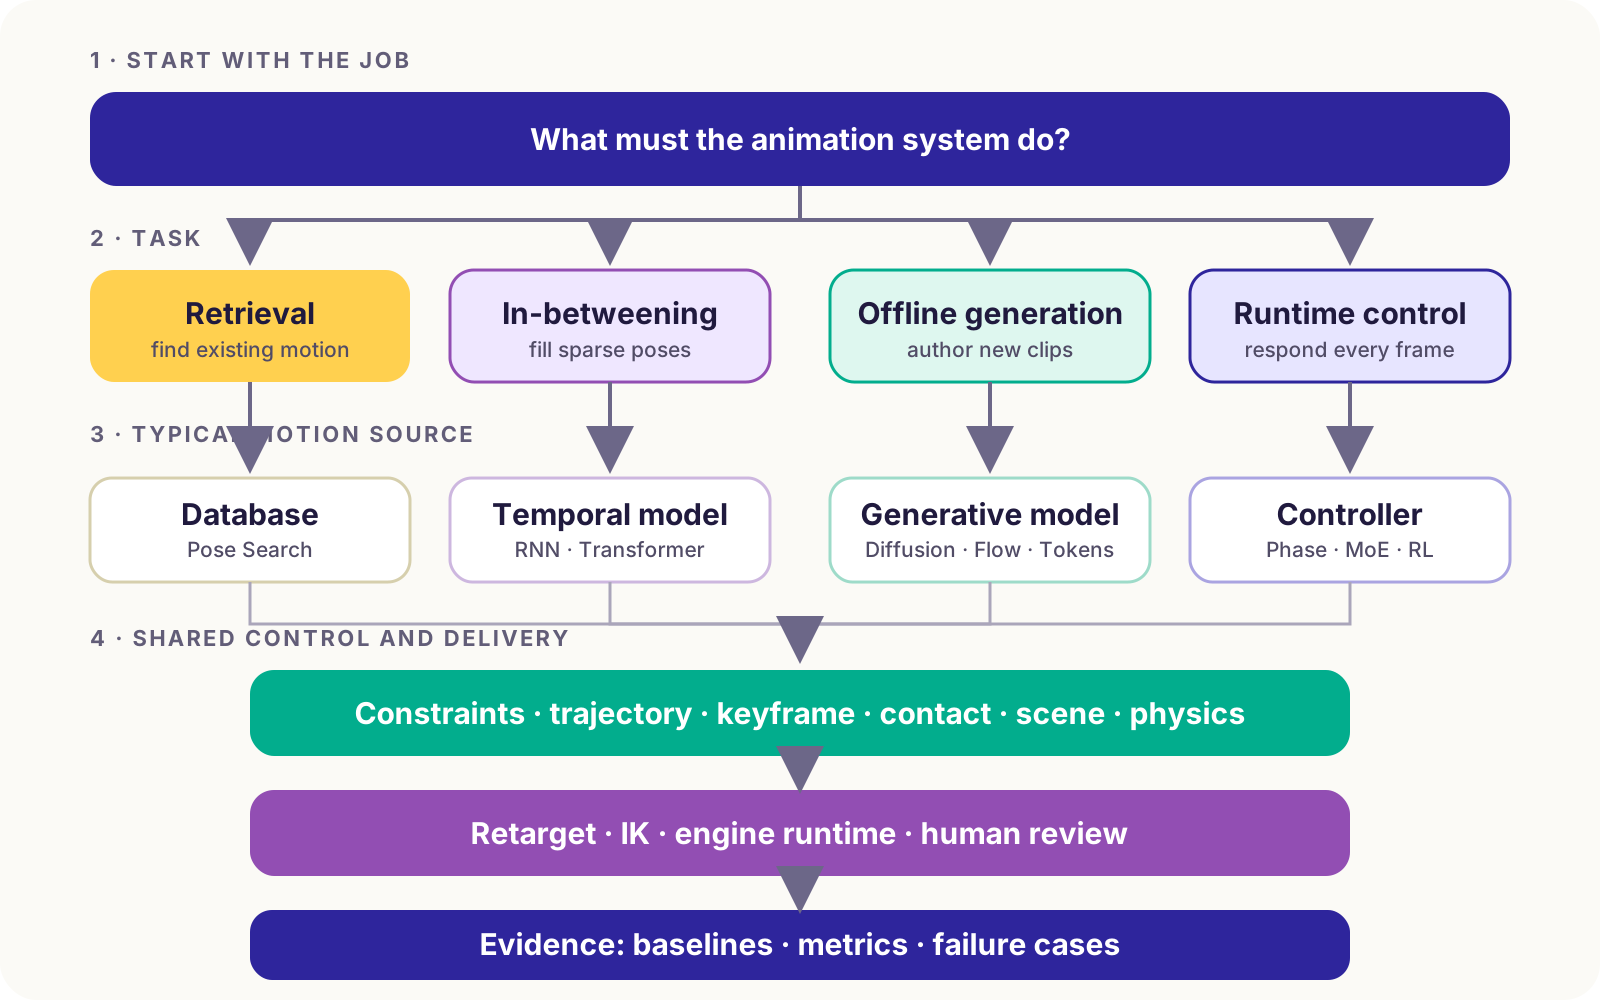
五个最容易混淆的概念
1. Retrieval:Motion Matching 不是“生成”
Motion Matching 每帧根据当前 Pose、速度和期望轨迹,从动作数据库里寻找最合适的片段。它不会凭空创造新动作,因此输出质量上限很大程度来自原始 mocap;代价是需要足够好的数据库、特征和切换策略。
它在生产中的价值恰恰来自这种“保守”:结果可追溯、可调试,动画师也知道失败通常来自数据库覆盖或查询代价,而不是不可解释的采样。
2. In-betweening:给稀疏约束,补出连续过渡
In-betweening 接收首尾关键帧或更稀疏的 Pose 约束,生成中间帧。Ubisoft La Forge 的 Robust Motion In-betweening 官方项目页 介绍了以 adversarial recurrent network、time-to-arrival 与 target noise 处理可变过渡长度和目标扰动的方法。
这类系统特别适合“动画师已经决定从哪里到哪里,但不想手工补满所有帧”的场景。它不等于开放式动作创作:当首尾动作语义差异过大、过渡过长或接触关系复杂时,模型仍可能给出平滑但不合理的路径。
我的 MotionIB scoped reproduction 也印证了这一点:连续 window 的 rollout、ONNX 对拍和 UE runtime 可以分别验证,但这些证据不能自动推出“任意 Anim A 到 Anim B 都已经达到生产质量”。
3. Offline Generation:从语义或风格创造一整段动作
文本到动作、标签到动作和风格化采样通常属于离线生成。Diffusion / Flow Matching 从噪声逐步得到动作;VQ 系列先把动作压成离散 token,再像语言模型一样补全或续写。
它们的优势是多样性和条件灵活,弱点则经常落在精确接触、长时一致性与可编辑性。一个“看起来像搬箱子”的动作,不代表手掌真的命中了箱子,也不代表它能无缝接进下一段动画。
KIMODO 的案例评测 更适合被理解为“Text + Kinematic Constraints 的离线 motion authoring”:Prompt 提供动作意图,约束负责路径或关键姿势;两者都不能替代场景语义、碰撞或动力学。
4. Runtime Control:真正的门槛是闭环延迟与稳定性
Runtime Control 不是“把离线模型跑快一点”这么简单。系统要持续消费玩家轨迹、当前状态与目标,在严格帧预算内输出下一 Pose,并且在长时间运行中不漂移、不脚滑、可被状态机和动画图接管。
Phase Functioned Networks、Mixture of Experts、轻量 recurrent controller,以及经过蒸馏的生成模型都可能服务这个目标。UE 5.8 AnimGen 实验 展示了另一种组合:先用 AutoEncoder 学连续 pose latent,再训练带 Behavior 条件的 Controller,最终把推理压到适合 Anim BP 的路径。
5. Constraint:它不是第五种模型,而是控制接口
Root path、full-body keyframe、手脚 end-effector、contact 与 collision 都属于约束,但约束的“命中”不等于动作的“可信”。
- Root constraint 能决定角色去哪,但未必产生正确的起步、刹车或重心转移。
- Hand target 能让手靠近某点,但物体朝向、抓握形态和受力仍需要额外表示。
- Full-body keyframe 能固定一个瞬间,却不能自动解释前因后果。
- Physics 能保证接触与平衡,却增加训练成本,也减少导演式控制的直接性。
NVIDIA 的 MotionBricks 把 proxy keyframes 做成 smart primitives,由生成 backbone 补 approach、contact 和 follow-through;KIMODO 则显式组合 text 与多类 kinematic constraints。两者都说明:越接近生产,模型越需要一个可编辑的控制面,而不只是更长的 Prompt。
七类常见技术范式
| 范式 | 运动从哪里来 | 最适合 | 常见边界 |
|---|---|---|---|
| Motion Matching / Pose Search | 从动作库检索 | 高质量 runtime locomotion | 依赖数据库覆盖,不创造真正的新动作 |
| Phase / MoE Controller | 小网络逐帧预测 | 周期运动、实时控制 | 相位与接触数据工程重,长尾动作弱 |
| RNN / Transformer In-betweening | 由稀疏关键帧递推或并行补全 | 过渡、动画师补帧 | 长过渡、大位移和跨语义转换更难 |
| Diffusion / Flow Matching | 从噪声迭代生成连续动作 | 多样化生成、复杂条件 | 多步采样慢;精确接触需要额外约束 |
| VQ token + Masked / AR | 在离散动作词表里补 token | 统一生成、补帧和多模态条件 | 量化上限与 codebook 设计会影响细节 |
| AutoEncoder / VAE / Flow | 在连续 latent 中表示动作分布 | 压缩、插值、其他生成器的底座 | 单独使用时可能过平滑,通常不是完整产品 |
| Physics-based RL | 在仿真中学习控制策略 | 受力、平衡、密集接触 | 训练和调参昂贵,精确导演更困难 |
这些范式不是产品菜单中的单选题。例如 AnimGen 是 AutoEncoder 底座加 Flow Matching Controller;MotionBricks 是离散 latent backbone 加 smart primitives;生产角色还可能在生成后接 Motion Warping、Full Body IK、碰撞和人工审核。
一个更可靠的选型顺序
场景 A:让角色在游戏里稳定移动
先把 Motion Matching / Pose Search 作为可解释基线。如果动作覆盖不足、控制维度复杂或需要生成多样性,再评估 Phase/MoE 或实时生成模型。验收时看的是持续运行、切换、多人预算和失败回退,不只是一段 demo。
场景 B:动画师已经有首尾 Pose
优先评估 In-betweening。先做插值基线,再用 L2P、L2Q、NPSS、foot skate 与人工观看共同判断。模型指标胜过插值只是第一关;真正的交付还需要 retarget、接触修正和可编辑曲线。
场景 C:从文本批量探索动作草稿
使用 Diffusion 或 motion-token 模型,把 Prompt 当作召回意图,而不是逐帧脚本。要求系统一次给多个 candidate,并记录 seed、duration、CFG、约束和失败原因。复杂动作拆段之后,仍要显式处理跨段状态与语义指代。
场景 D:手、脚、道具必须精确接触
把接触建模成一等输入:关键帧、end-effector、object proxy 或 scene constraint。生成后再用 IK / physics 做闭环校正。只增加文本描述通常不会自动带来厘米级命中。
场景 E:角色要承受外力并保持平衡
Physics-based RL 或 tracking policy 更接近问题本质。动画生成器可以提供 reference motion,但“动作像真的”与“动力学上站得住”仍是两个不同目标。
别把论文数字做成排行榜
同样是“2 ms”或“实时”,背后可能是:单帧 latency、整段 batch throughput、CPU、GPU、不同 skeleton、不同序列长度,甚至只统计 neural network 而不含数据搬运和 retarget。
我更倾向为每个结论保存一个最小实验契约:
输入定义 + Skeleton / FPS
模型与 checkpoint
硬件与 runtime
计时边界(包含什么、不包含什么)
质量指标 + 插值/检索基线
可视证据 + 明确失败案例
只有这些条件一致,数字才适合比较。否则,它最多说明“这个系统在自己的设置中证明了某种可能性”。
我现在怎样理解“AI 动画系统”
它不是一个模型,而是一条闭环:
需求与导演意图
  → 数据 / 动作库 / Reference
  → 检索或生成
  → 轨迹、关键帧与接触约束
  → Retarget、IK、Physics、Engine Runtime
  → 自动指标 + 人工审核
  → 失败回到数据、控制或任务定义
模型决定“能提出什么候选”,约束决定“候选要满足什么”,引擎与后处理决定“能否交付”,证据链决定“我们到底验证了什么”。这也是这个 AI Animation research track 后续文章共同采用的结构。
主要参考
- Ubisoft La Forge, Robust Motion In-betweening, SIGGRAPH 2020.
- Tevet et al., Human Motion Diffusion Model.
- Chen et al., Executing your Commands via Motion Diffusion in Latent Space.
- Zhang et al., Phase-Functioned Neural Networks for Character Control.
- Peng et al., DeepMimic.
- NVIDIA, MotionBricks and KIMODO.
本文最初调研于 2026-06-10;publishedAt 使用主来源最后一次有意义修订日期 2026-07-03。