Case Study
UE 5.8 官方 MCP:从 237 个工具到可验证工作流
在 2026 年 5 月的 UE 5.8 Preview 中,用 22 个核心 Toolset 的原子测试与业务任务,拆解 AI 操控 Editor 真正需要的 discover → plan → execute → verify 闭环。
一个 AI 能列出 237 个工具,不等于它能可靠地改好一个 Unreal Engine 项目。
真正的问题是:它能否先找到正确的对象和 schema,给出可回退的计划,执行后拿到独立证据,并把结果保存到磁盘?这次实验把评估重心从“工具数量”移到了这条工程闭环上。
快照声明:文中的 22 个核心 Toolset、237 个工具与 7/10 都是 2026 年 5 月、UE 5.8 Preview 的测试结果,不是对当前 UE 版本的实时盘点,也不是长期不变的产品评分。
先把“能调用”拆成三层测试
我没有从一个大型自动化任务直接开始,而是把测试拆成三层:
| 层级 | 要回答的问题 | 证据 |
|---|---|---|
| 原子测试 | 单个 tool 的参数、返回与副作用是否符合 schema? | 读、写、readback、cleanup |
| 业务任务 | 多个 tool 能否按正确顺序完成一项 Editor 工作? | 资产、图结构、编译与保存状态 |
| 集成切片 | 多个 Toolset 串联后,是否还能维持上下文、验证和恢复能力? | 可运行切片、PIE 行为与最终清理 |
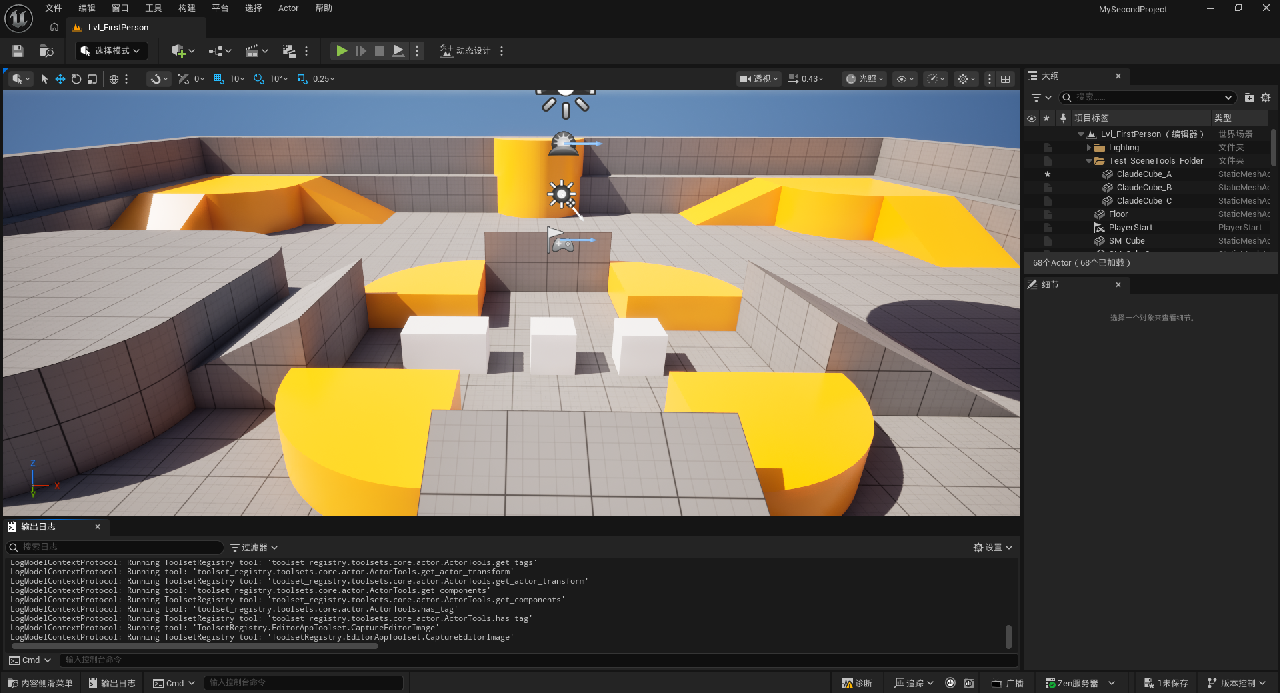
原子层覆盖了 AllToolsets 核心包中的 22 个 Toolset、237 个工具。场景、Actor、资产、材质、DataTable、日志和沙盒批处理等能力已经足以完成大量 Editor 自动化;Blueprint 图编辑也能工作,但 discovery 成本和本地化问题明显更高。
这也是 7/10 的来源:覆盖范围在当时已经很强,但可靠性仍依赖调用方自己补齐一层工作流。
可靠性的主线:discover → plan → execute → verify
Discover                 Plan                     Execute                  Verify
真实 refPath / type_id   拆分读、写、保存点        小步写入或安全批处理       readback
属性 schema / pin        标出高风险与回退方式      高风险操作放在末尾         compile
当前资产与场景状态        选择单步还是 batch        每批留下检查点             PIE runtime
                                                                          save / reopen
这四步不是形式化包装,而是在实测里分别挡住了不同类型的失败。
1. Discover:静态 schema 不是运行时真相
Blueprint 是最典型的例子。create_node 的 schema 示例给出了英文 type_id,但中文 Editor 会把分类名本地化;照抄示例可能得到一个根本不存在的 ID。正确做法是先用 find_node_types 找到当前 Editor 真正接受的标识,再用 get_node_info 读取 pin,最后才创建和连线。
同样的纪律也适用于 UObject 属性、DataTable RowStruct 与资产路径:先通过只读工具发现,再写入。猜一个“看起来合理”的名字,代价可能不是一次失败返回,而是整段脚本中断,而且已经发生的副作用不会自动回滚。
2. Plan:把保存与验证写进计划,而不是事后补救
一份可执行计划至少要明确四件事:
- 哪些调用只读,哪些会改变 Editor 状态;
- 每个写操作用什么只读调用回读;
- 何时 compile、何时进入 PIE;
- 哪个批次结束后调用 save。
测试中曾出现过场景修改已经返回成功、但 Editor 崩溃前没有保存,导致整个阶段重做的情况。MCP 改动首先存在于 Editor 内存里,true 并不等于已经持久化。
3. Execute:小步写入,重复任务再批处理
单个 Blueprint 节点、陌生属性或高风险路径适合小步执行:每加一到两个节点就读取图结构并 compile。相反,重复放置、打 tag、整理文件夹一类任务,如果 N 大于约 3,逐次 MCP round-trip 会同时放大延迟和上下文消耗。
这时 ProgrammaticToolset 更合适:在受限 Python 沙盒中循环调用其他 Toolset,把多次同构操作压进一个批次。但 batch 不是事务。只要中间出现非法 refPath、属性名或 type_id,脚本可能中断,之前的写入仍然存在。因此我采用的规则是:
- 先用独立只读探针确认所有 ID 与路径;
- 把可重复、低风险的写入放在同一批;
- 把高风险 set 放到批次末尾;
- 批次结束立即 readback,并在持久化边界 save。
“N > 3 就考虑 batch”是这次环境里的经验阈值,不是引擎 API 的硬规则。任务复杂度、失败代价和可观测性比纯数量更重要。
4. Verify:返回值、编译、运行与保存是四件事
最危险的误判,是把某一层成功当成全部成功。
| 信号 | 它能证明什么 | 它不能证明什么 |
|---|---|---|
tool 返回 null |
对 void 函数来说可能完全正常 | 不能证明成功,也不能证明失败 |
setter 返回 true |
调用被接收 | 不能证明每个字段都实际写入 |
| 属性 / 图结构 readback | Editor 当前内存状态符合预期 | 不能证明已保存或 runtime 生效 |
| Blueprint compile clean | 图结构和类型通过编译 | 不能证明事件会在 PIE 中触发 |
| PIE 行为正确 | 本次运行时路径被走到 | 不能证明重启后资产仍存在 |
| save 后重读 | 资产已经越过持久化边界 | 不能替代长期稳定性测试 |
这也解释了为什么截图不应承担全部验证。截图适合展示,但对象数量、transform、连接关系和参数值更适合用结构化 readback;行为逻辑则必须进入 PIE。
两个最容易制造“假成功”的返回陷阱
static schema trap
静态工具描述只能告诉模型“可能有哪些参数”,不能保证示例 ID、属性拼写和本地化后的运行时对象一致。尤其在 Blueprint 图编辑中,先 discovery 再 create 是必要步骤。
void return trap
set_actor_folder、add_tag、connect_pins 等 void 工具会返回 null。与此同时,部分 setter 即使忽略了格式错误的 struct 值,也可能返回 true。所以可靠性不能建立在返回值的真假上,而要建立在一个独立、只读、可比较的后置条件上。
例如一次 Blueprint 修改的最小可靠链路是:
find_node_types
  → create_node
  → get_node_info
  → connect_pins
  → get_graph_info
  → compile_blueprint
  → PIE 验证行为
  → save_assets
最终结论:值得用,但不能裸用
UE 5.8 Preview 的官方 MCP 在这次快照里已经覆盖了相当宽的 Editor 表面。它最有价值的地方不是“LLM 能替人点击”,而是场景、资产、反射、图编辑和批处理开始共享一种可编排的接口。
但它还不是无人值守的生产系统。可靠使用需要额外的一层 Skill 或 orchestration,把真实 ID discovery、参数规范、分批执行、readback、compile、PIE 与 save 固化成默认步骤。没有这一层,工具越多,只会让失败空间更大。
可复用检查表
- 先发现真实
refPath、type_id、property 与 pin,再生成写操作。 - 每个写调用都配一个独立 readback;不要从
null或true推断最终状态。 - Blueprint 分块构建,每块都读图并 compile;行为必须进 PIE。
- 重要场景和资产每批 save,必要时重读确认。
N大于约 3 的同构操作优先评估ProgrammaticToolset,但不要把陌生高风险写入塞进一个大脚本。- 把失败路径、cleanup 与 session 重连纳入工作流。